IA

 7 min. de lecture
Publié le 29 décembre 2025


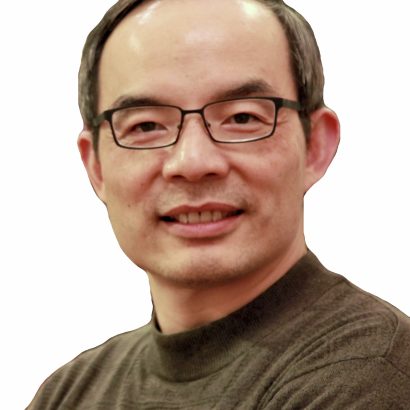
Xuedong Huang est le directeur informatique. Avant de rejoindre Zoom, il a occupé chez Microsoft le poste de directeur informatique et de Technical Fellow d’Azure AI. Son parcours dans le monde de l’IA est brillant : il a créé le groupe de technologie vocale de Microsoft en 1993 et organisé la mise en place, au sein de l’équipe d’IA de Microsoft, des premières mesures en faveur de la parité dans les domaines de la reconnaissance vocale, de la traduction automatique, de la compréhension du langage naturel et de la vision par ordinateur. Membre de l’IEEE et de l’ACM, il est également membre élu de la National Academy of Engineering et de l’American Academy of Arts and Sciences.
Xuedong Huang a obtenu un doctorat en génie électrique à l’université d’Édimbourg en 1989 (financé par l’ORS britannique et une bourse de l’université d’Édimbourg), une maîtrise en informatique à l’université Tsinghua en 1984 et une licence en informatique à l’université du Hunan en 1982.
|
Modèle/Système
|
Précision de DeepSearchQA
|
|
Zoom IA fédérée (GPT-5 + Gemini 3 Pro Preview)
|
76,3 %
|
|
Agent de recherche approfondie Google Gemini
|
66,1 %
|
|
OpenAI GPT‑5 Pro
|
65,2 %
|
|
OpenAI GPT-5
|
59,4 %
|
|
Google Gemini 3 Pro Preview
|
56,6 %
|
|
Anthropic Claude Opus 4.5 (réflexion)
|
24,0 %
|
|
Modèle/Système
|
Précision complète HLE
|
|
Zoom AI fédérée
(GPT-5.2 + Gemini 3 Pro Preview)
|
53,0 %
|
|
OpenAI GPT‑5.2 Pro
|
|
|
Zoom AI fédérée
(GPT-5 + Gemini 3 Pro Preview)
|
48,1 %
|
|
Agent de recherche approfondie Google Gemini
|
|
|
Google Gemini 3 Pro Preview
|
|
|
OpenAI GPT‑5.2
|
|
|
Anthropic Claude Opus 4.5
|
|
|
OpenAI GPT-5 Pro
|
|
|
OpenAI GPT-5
|
 9 min. de lecture
Les systèmes d’IA agentique utilisent des grands modèles de langage (LLM) pour décomposer des objectifs complexes en une série d’actions réalisables. Poursuivez votre lecture pour découvrir des exemples et comprendre leur fonctionnement.
Nos dirigeants prédisent l’impact de la technologie IA sur l’année 2026 à partir de ces tendances clés. Découvrez ce que vous réserve l’année à venir.